首页> 详情

基于经典测量理论和项目反应理论的等值与连接(一)

2012-08-31 |浏览:5167次 | 编辑: 加载失败
分享到: 
副标题#e#

约瑟夫·M·瑞安(Joseph M Ryan)博士,1968年毕业于美国波士顿学院的数学系,1969年获得该校教育心理学硕士学位,1977年获得芝加哥大学教育测量、评价及统计分析博士学位。1974—2006年先后供职于美国南卡罗来纳大学及亚利桑那州立大学,分别担任过这两所大学教育学院和教师学院的系主任、中心主任。

瑞安教授从事教育评价和测量咨询专家工作已超过20年。他与美国中小学、学区、州教育部以及考试机构密切合作,为其开展了广泛的教育咨询服务。目前,瑞安博士仍担任了包括阿拉斯加、爱德华、康涅狄格、俄亥俄,德克萨斯,以及华盛顿在内的美国多个州的教育技术顾问委员会(the Technical Advisory Committees)的委员,并参与了超过12个州的教育评价与测试工作。瑞安博士的研究专长有量化、等值、成绩报告、标准设立、偏差或者项目功能差异(DIF)分析。他对教育机构提供给学生、教师、父母等的有指导信息的报告的程序和方式非常感兴趣。

瑞安博士学术成就卓著,发表了上百篇论文与多部重要专著。近年来他在教育测量与评价领域的重要著作包括:A practitioner’s introduction to linking and equating, ( the Council of Chief State School Officers,2010 );Practices, issues, and trends in student test score reporting, (S. Downing, T. Haladyana Eds.,2006 ); The Handbook of Test Development,(Lawrence Earlbaum Associates: Mahwah,NJ.,2006 );Large-scale assessment programs for all students: Validity, technical adequacy, and implementation, ( Lawrence Earlbaum Associates:Mahwah,NJ.,2002 )等。

#p#副标题#e#

导  言

笔者连续写作了三篇论文来审视测验等值和连接中涉及的概念、程序、应用以及碰到的问题等,本文是这一系列论文的开篇之作。本系列论文是面向开发、维护和改进教育测量项目的教育工作者所创作的,其目标读者群包括教育测量的用户、从业者以及负责教育测量项目的政策制定者。当然,对于其他想对连接与等值做一些基础的了解,从而进行更深入的技术学习的人士来说,这些论文也是非常实用的基础知识。

文中使用了许多教育测量的实例来说明涉及的概念与程序,这些实例和说明都是在美国以及世界其他地区常见的实践和方法。这些情况说明,在教育测量中等值已经发展成为了能够应用于特定的目标、满足特定要求的手段。然而,我们也需要认识到,这些教育测量的案例并非放之四海而皆准,而且其仅仅是说明性的而非规定性的。例如,这些论文很大程度上是以美国教育研究协会(American Educational Research Association,简称AERA)、美国心理协会(American Psychological Association,简称APA)和美国教育测量学会( National Council on Measurement in Education,简称NCME)编制的《教育与心理测试标准》(1999)为基础的,其中收录的内容都是一些得到了广泛认可的书面准则和教育测量中的惯例,但是其应用必须要和教育测量中的教育与文化背景结合起来。

#p#副标题#e#

一、等值与连接中的效度概念、测试目的与测试规范

(一)效度的概念

在所有的测评项目中,效度都是人们最关心的问题。在构建测评过程中的每一个阶段,人们都必须对效度证明作出正式的记录。《教育与心理测试标准》中给效度的定义是:“在测试目标要求之下,证据和理论能够支持对测试成绩进行解释的程度。”(AERA,APA,NCME, 1999,第9页)该标准还指出,“逻辑上说,效度测量开始于对测试成绩的解释给出明确的说明”,而且,这样的解释“需要能够体现测试意图考察的构想或者概念”(AERA等,第9页)。

在许多测评项目中,针对效度的此种观点可以这样理解:即要求考试开发者对学生需要在考试中掌握的知识和技能作出清晰、明确的解释,从而确保测试的可靠性。假如没有一个清晰、明确的对学生的要求,一项测试想要有效地衡量学生的学习水平虽然不是完全不可能,却也是相当困难的。

Linn(2008)阐述了效度的含义,指出虽然人们常常随意地讨论测试的效度问题,一项测试中真正有效的其实并不是测试结果本身,而是这一结果的应用、解读和要求:

也许一些证据可以说明,对测试结果特定的应用会得到较高的效度;然而,同样的一个测试结果如果用于其他的目的,就可能毫无效度可言。例如,某一项测试或许能够显示出学生在某一个特定领域内所具备的知识和技能,从而对制定教学计划有所帮助;但是如果把这项测试成绩用于颁发高中毕业证书这样的高风险决定时,它的效度就不够充足了。

Sireci(2009)针对效度这个概念的历史作过一个颇为有趣而发人深省的叙述,他对效度作了三个和Linn颇为相似的评论:

(1)效度并不是一项测试的内在属性;

(2)效度与对测试成绩作出的解读和应用息息相关;

(3)衡量效度必须要考虑到测试的目的和应用。

以上是笔者对目前有关效度的观点做的一个简要的综述,我们从中能够看出,目前主张把效度看作测试结果解读和应用中的一个属性。这和传统观点中把效度看作一项测试的特征大不相同,而且这对“等值”这个概念的理解和评估有非常重要的意义。

#p#副标题#e#

(二)测试目的

教育测评项目中的测试成绩通常含有多方面的目的,其中包括但不局限于以下方面:利用测试成绩增强教师教学、学生学习的效果;衡量学生取得的进步;评估不同课程体系和教学方法的效率。此外,将测试成绩与其他一些信息相结合,可以对学生未来的学术和其他成就作出预测。因此,要对两个不同的测试版本进行等值,实际上就是要求这两个测试版本能够同样有效、完满地实现该项测评的目的。

对于大规模的测试项目来说,等值是非常重要的。因为同一考试机构会使用大量不同的试卷,而且这些试卷每年(甚至更频繁)还都会有所变化。这样的测试项目面临的主要挑战在于,由于不同的测试版本所考查的内容和目的是一致的,它们之间的评分标准和意义需要保持一致。这就是对测试的效度提出的考验,因此在构建不同版本的测试时,保证测试成绩具有一致的解释并能一样完美地服务于相同测试目的是非常关键的。

(三)测试规范(test specifications)

在这一系列论文中,笔者所关注的焦点是测试等值与连接中技术上、心理测量上的概念和程序。然而,要想取得测试等值的成功,最有价值的步骤却不在统计或者心理测量的范围之内。事实上,测试等值中最关键的环节一是在于为不同的测试版本准备相似的题目;二是在不同的试卷版本中有同等的涵盖考查内容相同、认知水平相同、试题模式相同的题目。

编制试题和测试规范的活动本身就是一项制定规范的过程,而且这项活动所需要的东西往往会超出心理测量专家的经验和专业知识。在目前对于学生应该掌握的知识和技能所进行的系统性描述中,存在很多不同的框架。Bloom(1956)所著的《教育目标分类》也许是其中最知名的经典原型,在该书所提出的框架中,对学习的定义是从知识的认知过程角度进行的,包括:识记、理解、应用、分析、综合、评估。想要构建等值的测试版本,各个版本中就需要等量地涵盖考查以上几个认知层次的题目,而且所考查的内容也要相同。Anderson& Krathwohl(2001)在他们的大作《学习、教学、评估分类: Bloom的教育目标分类的修改》中,针对Bloom的观点提出了很有意义的补充。另外还有一些有影响力的机构和学者也提出了他们自己对学习分类的框架,包括美国教育进展评估(National Assessment of Educational Progress, NAEP)、Robert Marzano与John Kendall(2007)和Norman Webb(1997)等,这些框架都提出了一组与认知过程或知识内容有关的学习维度。

最关键的问题并不是该采用哪一种框架,而是人们必须编制出一套清晰、明确、通俗易懂的方法来说明试题和测试所考查的具体是什么,而且要将这一套说明方法当作编制试题和试卷的蓝本。假如不能对测试的考核内容作出清晰的定义,我们无法想象这个测试的效度将如何评价。

测试规范中除了内容和认知过程以外,还包括试题的形式和呈现方式。试题的呈现方式包括纸笔测试、计算机化测试(computer based administration of fixed test)和计算机适应性测试三种(Mills等, 2002)。试题形式则包括选择答案题型(如选择题、判断题、连线题等)、自拟答案题型(如简答题、延伸题等)和完成任务题型(如编制图表、完成实验等)。测试规范中有必要包括对试题形式和呈现方式的说明,这样一来,测试规范就包括学习内容、认知过程、试题形式和呈现模式四个部分。

对试题和测试规范的讨论并不总是出现在对等值与连接的论述中。然而,在试题命制的过程中尽可能地保持试题和试卷的相似性是实现等值的重要环节。如果不同的测试版本在内容、认知过程、试题形式、呈现方式上都很匹配,那么对成绩进行的等值实际上就是在试题命制阶段的“等值”的基础上进行的细微改良。反之,如果测试在以上几个重要方面都不相匹配,学生的测试成绩就会受到影响,等值操作仍然能够得出一个数字上的结果,但是这个结果却无法使试卷实现“等值”。

#p#副标题#e#

二、等值与连接:意义和困惑

(一)等值与连接的基本概念

“等值”(equating)是一个测量术语,指的是为了在两个及以上的测试版本的成绩之间建立成对关联,使之具有同样的意义而设计的一系列程序。在将两个不同测试版本的成绩进行等值时,包含两重意义:第一层就是简简单单地让不同测试版本的原始成绩或者衍生成绩之间可以转化、对应或者相提并论,从而能够替换使用;第二层意义则远不止对应成绩那么简单,它让不同的成绩通过等值后能够体现对考生知识、能力相同的解读和推断,而且在此基础上能够进一步采取相同的适当的行动。

等值是一个能够在同一项测试的不同版本之间构建具有相同意义的并可比较成绩的技术程序,有了它,不同的考卷就可以替换使用。只要进行过确实的等值操作,某个学生或者某组考生用哪一套试卷进行测试就变得无关紧要了。在许多大规模的测试项目中,等值都有非常关键的作用,因为这一类测试都需要使用不止一套试卷。在各种现实原因的影响下,同一个测试机构可能会使用大量不同的试卷。此外,试卷的形式也会逐年发生变化,甚至频率要更高。

人们对连接(linking)和等值(equating)两个术语经常混淆,有时还替换使用。连接是更广泛的术语,对两个测试版本建立相配或者成对的关系,并没有要求该成对的成绩具有相同的实质含义。连接和等值是不同概念,连接对成绩的解释能力弱于等值。人们的困惑有些可能源于它们两个都采用相同的技术步骤。同时,某些步骤如“等百分位等值”(equipercentile equating)已经成为测量和心理测量学常用的词组。连接测试即使采用“等百分位等值”也不一定导致形成等值的测试版本。

在连接与等值中,一份试卷得出的成绩要和另一份试卷的成绩建立相配或者成对的关系。换句话说,一份试卷的成绩需要转化到与另一份成绩相同的量表或者一份通用量表上去。例如,在标准型测试(standards-based assessment,t简称SBA,即以检验固定的标准内容为目的的测试)中得出的成绩,将能够连接或者对应到标准的常模参照测试(norm-referenced test,简称NRT)成绩上去。通过这样的连接,我们可以得到一个两列的表格,其中的每一行都将一个标准型测试(SBA)成绩与一个常模参照测试(NRT)成绩联系起来(反之亦然),这样就将两个测试成绩连接起来了,如表1。
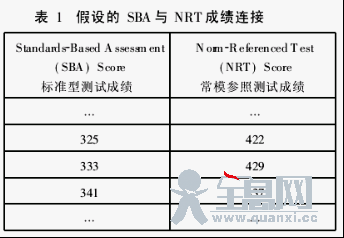
 

这样的连接可以用如下的短语进行恰当地描述:

“在标准型测试中得分为325的学生将极有可能在常模参照测试中得到422分。”“在常模参照测试中得到437分的学生很可能在标准型测试中得到341分。”

相比于仅仅将两个测试的成绩连接在一起,对两个测试所做的等值具有更强的意义。例如,如果我们成功地将一项于2009年进行的五年级数学考试与2010年进行的相同的考试等值起来,我们可以说:“就所考查内容的范围来说,在两次测试中取得相同成绩的学生所掌握的知识与技能的水平也是相同的。”

当我们说这两份试卷是“等值的”时,我们所表达的意思就是:它们考查的是相同的内容和认知程度,对学生掌握的知识、技能作出了相同的解读和推断。有了这些强有力的断言,我们就能够在包括一些对学生和其他人意义重大的测试中替换使用等值的试题版本。

但是,如果我们说两份试卷是“连接的”,那意义就大不一样了。连接能够说明不同测试的成绩之间是相互关联的,但是却无法说明这些测试具有相同的解读、推断以及成绩的互相使用是有效的。和连接一样,等值也可以说明两个测试之间的关联,但是它还具有更深一层的含义,那就是这一对成绩含有相同的实质意义。

要想区别连接与等值,我们可以把等值看做“连接”这个连续统一体上的一个极端,如图1所示。

这个连续统一体的右侧所表现出的,就是在有意构建的等值测试中所表现出的测量状况。此时,两个(甚至多个)不同的测试就可以正式沿着一定的程序进行等值(具体操作在本系列论文的另外篇章中将作交代)。针对同一内容、属于同一年级的测试将会被设计成尽可能的相似,这样一来所得出的运算数据就可以直接用于等值之中。图1的左侧所表示的则是另外的情况——两个不同的测试成绩的连接,此时,我们不能说某一个测试的成绩与另一个测试成绩具有相同的意义。

分布在这个连续统一体两端之间的,则是一些严格意义上说近似于等值的测量状况,但是这些状况仍不能完全满足等值的要求。Mislevy(1992)对这一分布作出了说明,他将测试之间的连接分成了四类:调整(moderation )、推算(projection)、校准(calibration)和等值(equating) (Mislevy,1992,第21~26页)。在他的模型中,调整是最弱的一类连接,而等值则是最强的,可以让不同的测试成绩最大程度地替换使用(这四个术语将在后面的文章中详细说明)。

如图2所示,右侧的等值是最强的一种连接,其他较弱的连接则都在图的左侧。在这个图中,达到等值一侧的连接需要更严格的要求,以使两个或者多个测试版本能够替换使用,那些无法达到这些严格标准的连接可以说是“像右侧运动”,但是仍旧不算是等值。

#p#副标题#e#

(二)等值与连接中的基本术语

这一部分中,笔者将对等值与连接中一些重要术语作简要的定义,以期能够用大众的、简单的语言来理解等值与连接中更多的细节。以下所有术语和程序都会在系列中的另一篇文章里作详细的论述。这里所收录的术语并没有网罗全部,主要集中于等值中所有最基础、最重要的术语和概念。

1.锚题、共同题、连接题(anchor items/common items/linking items)。这三个术语经常替换使用,在本系列论文中将通称锚题。所谓锚题,是指在两份或两份以上的试卷中出现的一组相同的题目。这些题目会像“锚”一样,起到稳定等值所需的测量量表的作用。这些在两份及以上的试卷中通用的题目还能够把不同的试卷“连接”到同一个量表上。

锚题的特征。锚题需要在内容和形式上与整个测试保持相近,还需要在题目顺序上与待等值的考卷相似。

增补锚题与嵌入锚题(appended and embedded anchor items)。出现在试卷末端的锚题是增补锚题,出现在试卷中不同位置的锚题是嵌入锚题。在等值中,嵌入锚题会比增补锚题发挥更大的作用。

锚题等值法。当使用锚题等值法时,等值方法包括等值常数法(the application of an equating constant)、固定校准法( the fixed calibration method)、同步校准法(the concurrent calibration method)、测试特征曲线法(the test characteristic curve method)等。

2.随机等值群(random equivalent groups)。这种随机选择学生参加不同考试的方法是一种很有价值的抽样方法。把从中得到的数据当做是同一个学生参加不同测试的情况,因而可以支持多种等值方法。

3.螺旋测试形式(spiraling test forms)。所谓螺旋,是指在一个学生群体(一个班或一所学校)内发放多种试卷形式。当不同的试卷(例如,试卷A、B、C、D)在同一个被测群体中随机发放时,往往就会出现螺旋。通常的做法是把不同的试卷按照比如ABCDABCDABCD这样的顺序放好,然后按顺序分发,拿到不同试卷的组群可以看做是随机等值组。

4.矩阵抽样(matrix sampling)。将题库中的题目分成不同的题组,再将它们分发给学生作答。不同的题组由不同的学生完成,这样每个人都不需要做完所有的题目,同时所有的题目都由足够多的学生做过了。这样的结果能够支持经典测量理论和项目反应理论的分析,也能够用于等值之中。

5.题库(item bank)。通常来说,题库指的是一组仔细归纳起来的试题,其中包括题目文字表述、阅读文段、图表、特别的题目属性、答案,以及从题目的预测和正式施测中得到的统计信息。在一个安全的题库中,只有命题人在命题时才能接触到其中的题目。也可以将一组题目或题库应用于平时测试、基准测验或者形成性评价。在等值的语境下,题库中的题目会以某种等值或连接的形式放置到一个通用的量表上。

6.预测(field testing)。预测是指用对学生进行不计分测试的方式检查试题的整体质量,并获得IRT题目参数的估计值。预测常用来开发原始题库和试用版的试卷。IRT值是否有用、建立在预测基础上的等值是否有效,这些都取决于预测和正式考试之间的相似度有多少。

7.多试卷版本、通用锚题(multiple forms, common anchors)。多试卷版本通常和一套通用的锚题一起使用。例如,如果需要等值的是试卷A、B、C和D,那么这四套题需要采用同一套锚题。

8.试卷间等值(form-to-form equating)。这种等值的方法就是将一系列试卷以两两结对的方式等值起来。例如,试卷A和试卷B可以由一套共用的锚题等值起来;试卷B和试卷C又可以由另一套共用的锚题等值起来;试卷C和试卷D也同理进行下去。理论上说,通过这种方法可以将所有的试卷都统一到一个测量量表上来。有时候它也被称做将所有的试卷“串联”起来。

9.横向等值(horizontal equating)。在大规模测试项目中最普遍的需求,就是在较长的时间里保持每个年级量表和行为评定标准的稳定。在同一年级或年龄阶段内的测试间进行的等值就是横向等值,横向等值是一种试卷间等值。

10.纵向量表化(vertical scaling)。纵向量表化是一个建立题库或者一系列试卷,使用等值程序建立跨年级或年龄的测试量表的过程。虽然它有时也称为纵向等值,但是在严格的等值定义下(例如应用环境和测试构念等值),它还达不到这样的要求。然而,如果把它看做不同年级测试之间的连接,则比较合适(Patz, 2007,第6页)。

11.预先等值(pre-equating)。预先等值是指利用提前确定的题目参数值,从题库中的题目里组建(construct)新的试卷的过程。新的试卷需要在IRT难度、内容、形式等方面符合测试规范的要求。在使用新试卷前,需要建立一张成绩对照表格,这张表格是基于现有的IRT题库值,显示量表的成绩和新试卷原始成绩的对应关系。

12.事后等值(post-equating)。事后等值顾名思义就是在学生参加测试之后对得到的成绩进行等值。事后等值最好取参加测试的全体考生的成绩进行,不过如果出成绩的时间要求比较紧,也可以选择一个“早期回收”(early return)的样本,但应选择一些有代表性的考生成绩进行。在时间和资源允许的情况下,我们强烈推荐使用事后等值而非预先等值。

13.试题参数偏离(item parameter drift)。当新试卷用到题库里或者别的试卷的试题时,通常会使用题目难度、区分度和猜测参数(后面将作介绍)的IRT参数估值,前提是这些参数保持稳定不变。然而在某些情况下,IRT参数值会发生变化或者偏离其题库值,而使用IRT方法时任何大的试题参数发生偏离都可能损害等值。试题参数偏离通常是在这种情况下发生的:题目已经使用了多次因而对目标考生群已经不陌生。

14.等值误差(equating error)。等值操作中的每一个步骤都会有来源不同的误差变量。除了试题参数偏离之外,还有试题本身的测量误差、样本误差、参数估算误差以及应用等值过程中产生的误差变量等。造成等值误差的变量来源很难确定,而且它们之间的关系是相互叠加而非相互消除的。以上是对笔者选出的若干重点术语、概念所作的简要介绍,在随后的文章中我们还会再次重点讨论。笔者将会通过更多的细节解释以上提到的术语、概念,也会继续介绍一些、解释一些新的术语和概念。有关连接与等值的细节问题的讨论可以参看Kolen与Brennan(2004),Holland与Dorans(2006),以及Dorans,Pommerich与Holland(2007)等相关文献。

#p#副标题#e#

三、经典测量理论和项目反应理论的基本概念

从技术角度看,适当的等值和连接程序都是建立在经典测量理论(CTT)和项目反应理论(IRT)基础上的。鉴于它们是所有等值程序的基础,笔者将在接下来的行文中简要介绍这两种测量学经典。在所有大规模测试项目中CTT都具有非常重要的地位,即使大部分的测试主要是在IRT方法的基础上建立的。本文会在非常基础的层面上介绍CTT和IRT中最主要的元素,因此感兴趣的读者可以参考Crocker与Algina ( 1986 )、Hambleton, Swaminathan与Rogers(1991),以及Yen与Fitzpatrick(2006)的论著以了解更深层的讨论。受过教育测量方面训练、特别是技术方面训练的读者,应该会对这些概念感到很熟悉,因此您可以选择略过以下的章节。

(一)经典测量理论的基础概念

CTT指的是一系列植根于20世纪早期的统计测量方法中的知识。与IRT形成鲜明对比的是,早期的CTT方法的重心在于观测分数。CTT的基础模型认为,观测分数是由两部分组成的:真分数(即在完美的测量条件下个体应得到的成绩)和误差(即题目或者测试中可能出现的不足、具体试题中的特质、学生水平发挥的差别或者其他真实成绩模型没有考虑到的因素)。

基础的CTT模型是这样的:学生在测试中的观测分数是由假设的无错误真分数加上若干随机误差组成的(Crocker& Algina,第107页)。这个基础模型可以用下面这个等式表达:

(Observed score= True score + Error)

其中,O代表观测分数,T代表真分数,E代表随机误差。关于这个模型中“误差”这一部分,学者提出了一些假设,即误差是随机的,与真分数没有关系,相互之间也不关联。

真分数模型及其假设直接导致信度的计算。信度是真分数方差与误差方差的比值。信度是衡量测量质量的一个重要指标。信度是成绩一致性的一个指标。经典方法把信度分成了三类:跨时间一致性(consistency over time,也叫测试——再测试test-retest),跨试题信度(consistency over test forms,也叫交替测试信度alternate form reliability)和试题内信度(consistency within form,也叫内在一致信度internal consistency reliability)。除了信度之外,CTT还非常强调效度的概念。CTT的效度概念运用于测试本身,也分成三类:内容效度、效标关联效度(criterion related)和构念效度。

在对测试题目进行分析时, CTT关注三个统计属性或者说题目特征:(1)难度,即正确回答一道题目的考生比例;(2)区分度,即题目难度在高水平样本和低水平样本之间的区别;(3)错误选项分析(item distractor analysis),即分析在选择题中选择单个错误答案的考生比例。在选择题目组成需要等值的平行试卷时,这三个属性是非常关键的。

经典测量理论和经典试题统计有许多优点,其中之一就是其计算程序非常简单易懂。此外,CTT方法已经在教育测量领域使用了数十年了,富有经验的测量专家和心理测量专家都对CTT很熟悉,也很了解其本质。CTT曾一度是测试和考生分析的标准测量范例,而且至今在试题命制、题目分析,甚至在以IRT为主的环境下仍得到非常广泛地应用。经典测量理论是为了支持对测试进行常模参照解读而建立的。当时,几乎所有的测试都以对学生进行分层、按成绩反映他们相对的成就等级为目的。在这一目标下,CTT对于支持和引导试题的命制和使用发挥了非常重要的作用。

CTT天生就带有一个重大的不足:它会在试题特征和考生特征之间建立起一种不可分离的相互依赖关系,而二者都建立在具体的测试题目和考生样本的基础上。经典统计或许能够体现一名学生的整体成绩,但也仅仅是就那一项测试的成绩而言。同样,有关试题的统计也只在特定的一群考生中才有效。举个例子,假如有一名学生在50道题中答对了48道,就此信息(这名学生的正确率达到了96% )判断,我们可以说该测试对于这名学生来说很简单,或者说该生将这项测试的内容学得很好。Hambleton等人(1991)这样说明了CTT的不足:

考生的能力是由某项具体测试来定义的。当测试很“难”时,他就会显得能力较低;当测试较“容易”时,他又会显得能力较高。那么我们说的“难”与“易”又是什么意思呢?一道题目的难度的定义是“同类考生中答题正确的比例”。试题的难易取决于受试学生的水平,而考生的水平高低则反过来又由试题的难易决定。(Hambleton,Swaminathan,&Rogers, 1991,第2~3页)

与CTT相关的群体水平依赖性(group-level dependencies)也会对命题人产生很重要的影响,因为如果未来要参加测试的学生和目前的考生很不相同,命制试题对他们来说就很具有挑战性:

很难把参加不同测试的考生放到一起对比,也很难对考生群体不同的测试进行对比。(并不是说这种对比是不可能的,测量专家已经在实践中设计出了处理这种问题的程序,但是概念性的问题依然存在)。(Hambleton等,第3页)

#p#副标题#e#

(二)项目反应理论的基本概念

项目反应理论(IRT)是指一系列基于考生的题目反应来分析测试题目并为考生制定量表的技术程序。IRT考虑的是考生所做的题目的特点以及他们对此作出的反应,并由其评价学生的能力。IRT能力测评要考虑学生的原始成绩,但是也会体现学生作答的题目的特点。例如,在使用IRT方法时,一名在20道较难的测试中做对了8道的考生,他所获得的能力评价就有可能比另一名在较简单的测试中答对了12道的考生高。

把IRT与CTT做比较有助于我们理解IRT的基础假设。在之前的论述中,笔者强调了CTT样本依赖(sample-dependent)的本质是其一个严重的不足。相比之下,IRT是建立在题目层面的统计与测量理论,并不依赖于一个特定的群体。更为重要的是,在IRT分析中,人和试题可以放在同一个量表上进行衡量,而且他们彼此之间相互独立。有时候人们也把IRT称为“现代测量理论”以区别于经典测量理论。

1.基础IRT模型

所有IRT模型都描述了考生做对一道题目的概率(此概率是由其与测试目的相关的个人能力决定的)。根据不同的IRT模型,一道题目最多体现出三种特征或者说参数。所有的IRT模型都假设认为,对于考生和试题的衡量都建立在其单维度的特质上,而且测试题目都是相互独立的。每个常见的IRT模型都会对等值的过程和主要等值决策带来不同的影响。目前最常用的三种IRT模型是:

·单参数Logistic模型(有时简称“1PL”或者“Rasch模型”)

·双参数Logistic模型(有时简称“2PL”)

·三参数Logistic模型(有时简称“3PL”)

由于单参数模型简单易见地体现了IRT方法共通的一些特性,笔者将以其为例简要介绍IRT模型主要的基本特征。Georg Rasch(1980)最先提出了这一基础模型,因此单参数模型经常也被称做Rasch模型。

单参数模型的得名是因为它仅从“难度”这一个方面厘定测试题目的特点。当使用这一模型时,衡量相关能力的原始分数可能从0到100(全对)都有分布。得到相同分数的学生就说明他们的能力相同,此时并不考虑他们答对的是哪几道题。图3所示的就是一个理想的单参数测量情境。笔者稍后还会用这类图形来说明一种常见的等值方法。在这个图表中,试题1代表简单试题,试题2代表中等难度的试题,试题3则代表较难的试题。

学生1的能力较差,学生2能力在中等水平,学生3和学生4的能力分别为较强和极强。在单维性的假设条件下,像学生4这样(能力最强)的学生答对试题3的概率就要大于学生2,学生2有可能答不对试题3。同样,虽然学生1、2、3都可能答不对试题3,但是其中学生1出错的可能性最大。最后,我们无法推论学生2能否正确回答试题2,因为试题2和学生2在量表上处于同一个位置;也就是说,学生2答对题目的概率是0.5,即答对答错的可能性各占一半。

图3说明的是单参数模型的情况,也就是仅仅考虑试题难度这一个特征时的情况。与之不同的是,双参数模型会考虑难度和区分度,三参数模型则会考虑难度、区分度和猜测。笔者稍后还会继续讨论这些模型。

①IRT模型中的题目特征曲线

IRT分析中非常重要的一个图表就是所谓题目特征曲线(item characteristic curve,简称ICC)。在图4中所展示的即是在单参数模型条件下假想的两条题目特征曲线。

在图4中,纵轴表示的是学生答题正确的概率,从0到1;横轴体现的是考生的能力水平,按照logit测量轴划定,原点为0。这两条曲线体现的是随着考生能力的提高,他们答题的正确率也随之上升。

在图4中确定一道题目的难度的方法就是在ICC曲线上找到对应纵轴(即正确答题的概率)为0. 5的点,然后再将这个点垂直投射到横轴上找到相应的位置。例如图4中曲线1所代表的试题1(curve1,曲线1)的难度为0,试题2(curve2,曲线2)的难度为1。说明试题2比试题1要难。也就是说,要想在做试题2时达到0. 5的正确率,考生的能力需要达到横轴上1的位置。


 图4中的曲线和由之产生的概率结论体现了单参数IRT模型的关键。在这个模型中,只有题目难度这一个试题特征(或者叫参数)影响学生正确作答的概率。然而,在某些情况下,测试成绩并不遵从单参数模型。在这种情况下,很多心理测量专家就会建议使用双参数或者三参数模型来解释这些成绩。

双参数模型使用了试题的两个参量:难度和区分度。这时试题的区分度就是ICC上正确率为0.5时曲线的斜率。当考生能力(即图4和图5中的X轴)的提高程度不变,而题目的区分度越高时,考生正确作答的概率(体现在图4和图5中的Y轴上)也会提高的更快。在大多数的实际情况中,有数据显示有一些试题在区分较高能力和较低能力的考生时的效果更加明显。如图4中两条ICC曲线说明两道题目的区分度是一样的,而在图5中的三条曲线则分别表示了三道区分度不同的题目。试题1的区分度最低,试题3区分度最高,而试题2的区分度则介乎于两者之间。

在图4中ICC的例子中,随着学生能力的不断降低,正确作答的概率越来越接近于0。然而,在真实情境下能力水平较低的学生也许会碰巧或者通过利用部分信息猜出正确的答案。三参数模型就在双参数模型的难度和区分度之外又加入了一个调整ICC曲线低端的第三参量——可能的猜测(guessing)。图5中显示试题3的ICC曲线对低端进行调整就考虑了学生答题中的“瞎蒙”这一行为。

②测试特征曲线

测试特征曲线(Test Characteristic Curve,简称TCC)是IRT中使用的一种非常重要的视觉表达手段,对最有用的等值方法之一意义重大。对所有的IRT模型来说,TCC就是测试中所有ICC的总和。TCC反映的是一项测试的期望原始成绩(纵轴所示)和以logit测量轴形式表现的IRT能力(横轴所示)之间的关系。图6展示了两条TCC曲线,它们表示了期望原始分数会随着IRT能力水平的提高而单调递增。在图6中,当IRT能力值为1时,试卷B的期望分数比试卷A的分数要高,这说明试卷B比试卷A要简单。换而言之,当横轴(IRT能力水平)上同一个值在试卷B的曲线上所对应的纵轴(原始成绩)值大于试卷A时,就可以说试卷B比试卷A简单。


#p#副标题#e#

2. IRT模型中的参数不变性和量表不定性

IRT程序的一个重要特点就是所谓“参数不变性”(parameter invariance)。IRT的参数不变性假设认为,学生的能力和试题的特征(难度、区分度、猜测)都是稳定的、一致的,即使在同一个人群里选择不同的样本也不会发生变化。

参数不变性(parameter invariance)是IRT的一个属性,其在现实中或多或少也是真实的。当然,试题的参数值仍然会出现变化,这可能由多种原因引起。例如,试题的参数值可能由于题目措辞或形式的细微变化而发生改变。此外,题目的位置变化、该题之前的题目顺序的改变、更多的集中提示等等,这些因素(还有很多可能不好发现)都可能造成参数值的一些变化。通过对模型拟合的检验,可以判定一组特定数据是否符合参数不变性的要求。

对于所有利用IRT模型进行等值的测试来说,其参数不变性的特征非常关键。它使得量表可以经由某个固定的原点以及稳定的考生和试题参数值建立。在这些值已知的前提下,后续的测试可以借由量表上的试题进行连接或等值。当对考生进行测量时,也就意味着只要量表确定了,无论采取哪一组试题,学生能力参数都不再变化。

量表不定性(scale indeterminacy)是指IRT分析要求赋予参数一个固定的初始值(Hambleton, Swaminathan, Rogers, 1991)。这个IRT量表固定的初始值可以是在量表上的任何一个有用的位置。实际操作中如果用单参数模型,通常把中等难度的题目放在量表正中间;如果用三参数模型,通常把平均能力的学生放在量表正中间。量表也可以固定在某一方便的位置,比如代表“熟练”水平的一点上。固定量表位置既解决了量表不定性同时又定义了可以推算稳定或者不变估算的量表。从任何量表转化到另一个量表是相对比较简单的,通常的方法是乘以或加上一些常数以改变方差和平均值(或者原点)。在IRT分析中,固定一些数值以解决量表不定性是非常关键的,特别是对一些以IRT为主的等值步骤。

3.数值、量表、量表化

在经典测量理论和项目反应理论中,一个重要问题就是采用什么数值或者量表来报告考试结果。最直接的量表也是大家都很熟悉的,即原始分数量表,简单讲就是测试中的成绩。同样大家也很熟悉的另一种,就是把原始分数重新量化成百分比,即百分比量表。

原始分数量表和百分比量表都有很多局限,其中最主要的问题就是它们都依赖试卷中某个特定系列的题目,并且容易引起不合适或者不准确的比较。用原始分数或者简单重新量表化的原始分数来判断学生的知识和能力可能导致错误的结论。

像前面文章里所述的IRT分析和IRT量表在推断学生们的知识能力,以及哪些题目较难或者较容易是非常有用的。例如, IRT软件在数学量表上使用“logit”这个单位进行计算,“logit”量表在数学运算上很方便,但也有一些缺点。首先,目前很少有人在使用;此外,没有IRT参数的固定自然原点(或者0点)。因此,只有固定初始参数值才能改正这种不确定性。

一旦用固定量表数值来解决IRT的不确定性,就可以预测题目参数和考生的logit值。但是这些结果仍然在logistic量表上,而这种量表大多数教育工作者并不熟悉。最后一步,量表可以很方便地转化为任何想要的报告量表,可以根据需要选择报告量表的平均值、标准差和(或)范围(参阅Crocker和Algina,1986,“转化成绩的步骤一览”)。

4.常见的IRT应用

在为新的试卷挑选题目时,基于IRT的计算能够提供很多详细的、题目相关的信息,这些都是非常有用的。如前文所述, IRT能够让命题人分析、解读学生和试题的特征,且不依赖于试题或群组的选择。与经典测量理论相比,其可以让命题人对考生可能的反应作出更好的预测。

IRT常被用来:

①提供可同时确定考生和试题在量表上位置的测量量表;

②可以将参加不同测试的考生定位在同一张量表上;

③有助于对试题质量、学生反应效度做出细致的检查。

最常见的IRT应用有:

①评价、审查试题和试卷;

②建立题库;

③对试卷进行连接或等值;

④根据题库建立等值试卷;

⑤制定内容参照型学生水平标准;

⑥提供内容参照型成绩解读;

⑦对试题的项目功能差异(意即对于不同组群的学生体现出来的成绩偏差)进行调查;

⑧支持计算机适应性测试。

IRT在以下领域具有较大的灵活性:

①设计不同的平行试卷;

②实施很适合学生水平的测试,使得能力较低的学生不会负荷过重,而能力较高的学生不会感觉太枯燥无聊;

③建立能力等级跨度范围更大的相关测试(可能跨两个或者更多年级);

④在试卷里插入或嵌入用于预测的新题,因而新题可以获得具有可比性的题目参数(最终用来组成新试卷)。

需要特别注意的是,上述说明和解释都非常概念化,对于CTT和IRT的简介也只包括其中最基本的概念,还有许多其他问题尚未涉及,建议想更深理解经典和现代测量理论的基础和技术的读者参阅文中提供的参考文献。

#p#副标题#e#

感谢

笔者以《一名业界人士对等值与连接的介绍及经典测验理论和项目反应理论入门》(A Practitioner’s Introduction to Equating with Primers on Classical Test Theory and Item Response Theory,Ryan&Brockmann,2009)一书和在美国教育测量协会(National Council on Measurement in Education,简称NCME)年度网络研讨会上的同名报告(科罗拉多州,丹佛, 2010)为基础,撰写了本系列论文。文中所使用的全部材料都得到了美国华盛顿特区的州重点学校管理者委员会(Council of Chief State School Officers,简称CCSSO)的许可,CCSSO对这些材料保有权利,并将在《考试研究》刊发这几篇论文之后刊载其英文版本。

在此,笔者想向美国华盛顿特区的州重点学校管理者委员会(CCSSO)给予本系列论文的慷慨支持表示感谢,这三篇论文正是建立在这种支持的基础上的。特别要感谢道格·兰多恩(Doug Rindone)和邓肯·麦奎利(Duncan MacQuarrie),因为他们在推进“华盛顿特区大规模评价的技术问题”(CCSSO Technical Issues in Large Scale Assessment,TILSA)这个项目中发挥了重要的作用。笔者还要特别向弗兰克·布罗克曼(Frank Brockmann),即《一名业界人士对等值与连接的介绍及经典测验理论和项目反应理论入门》一书的联合作者表示感谢,他细心地为本文做了审阅,而且文中所有数据和图表都是他准备的。莎伦·奥斯本·波普(Sharon Osborn Popp)和戴维·沙耶尔(David Chayer)博士也对本文做了细致的审阅,并提出了许多宝贵的意见,在此一并致以谢意。

#p#副标题#e#

参考文献:

[1]AERA,APA,&NCME,Standards for educational and psychological testing,Washington,D.C. Author,1999.

[2]Anderson,L.,& Krathwoh,l D.(Eds.),A taxonomy for learning,teaching,and assessing: A revision of Bloom’s taxonomy of educational objectives[Complete Edition], New York:Longman Publishing Group,2000.

[3]Bloom, B. S., Taxonomy of educational objectives,New York,NY:Longmans,Green& Co,1956.

[4]Crocker,L.,& Algina,J.,Introduction to classical and modern test theory,Belmont,CA:Wadsworth Group,1986.

[5]Dorans,N. J.,Pommerich,M.,& Holland, P.W., Linking and aligning scores and scales,Statistics for social and behavioral sciences,New York: Springer,2007.

[6 ]Hambleton, R., Swaminathan, H., & Rogers, H.,Fundamentals of item response theory,Newberry Park,CA: Sage,1991.

[7]Holland, P.,& Dorans,N., Linking and equating, In Brennan, R. L. ( Ed),Educational Measurement,4thed.,Westport,CT: Praeger Publishers,2006:187-220.

[8 ] Kolen,M. J.,& Brennan, R. L.,Test equating,scaling,and linking:Methods and practices,(2nd ed.), New York,NY:Springer,2004.

[9]Linn,R.,Validation of uses and interpretations of state assessments,Washington, DC: Council of Chief State School Officers,2008.

[10]Marzano, R. J. & Kendal,l J. S.,A new taxonomy of educational objectives(2nded.), Thousand Oaks,CA:Corwin Press,2007.

[11]Mills, C. N., Potenza, M. T., Fremer, J. J., and Ward,W. C.,Computer-based testing: Building the foundation for future assessments,Mahwah, NJ: Lawrence Earlbaum Associates, 2002.

[12 ] Mislevy, R. J.,Linking educational assessments: Concepts, issues, methods, and prospects,Princeton, NJ: Educational Testing Service, 1992.

[13 ] Patz, R. J.,Vertical scaling in standards-based educational assessment and accountability systems,Washington,DC:Council of Chief State School Officers, 2007.

[14]Rasch, G.,Probabilistic models for some intelligence and attainment tests,Chicago: University of Chicago Press,1980.

[ 15 ] Ryan, J., & Brockmann, F.,A practitioner s introduction to equating with primers on classical test theory and item response theory,Washington, DC: Council of Chief State School Officers, 2009.

[16]Sirec,i S., Packing and unpacking sources of validity evidence:History repeats itself again, In R.W. Lissitz (Ed.), The concept of validity: Revisions, new directions and applications,Charlotte, NC: Information Age Publishing, 2009:19-37.

[17]Webb,Norman L.,Criteria for alignment of expectations and assessments in mathematics and science education,National Institute for Science Education,University of Wisconsin-Madison;Washington,DC, the Council of Chief State School Officers,1997.

[18]Yen,W. N., and Fitzpatrick, A. R., Item response theory, In Brennan, R. L. (Ed),Educational Measurement,4th ed.,Westport,CT: Praeger Publishers,2006:111-153.


(责任编辑:王翔)


声明:文章版权归原作者所有,本文摘编仅作学习交流,非商业用途,所有文章都会注明来源,如有异议,请联系我们快速处理或删除,谢谢支持。


(原文章信息:标题:,作者:约瑟夫•M•瑞安,来源:考试研究 2011.1   &,来源地址:)

上一篇: 基于标准的考试命题技术(一)

下一篇: 基于标准的考试命题技术(二)

专题

-----主办-----

河南省乡村振兴协会

-----承办-----

河南省乡村振兴协会产业与信息化专业委员会

河南金农达供应链管理有限公司

河南全息农业科技有限公司 

-----协办-----

全息数字科技